
jju71 님의 블로그
Alien vs Predator 본문
1. Alien vs Predator 데이터셋
Alien vs Predator 데이터셋은 컴퓨터 비전과 이미지 분류 모델을 학습시키기 위해 제공하는 소규모 데이터셋입니다.
이 데이터셋은 영화 속 캐릭터인 에일리언(Alien)과 프레데터(Predator)의 이미지로 구성되어 있습니다. 이 데이터를 통해 이 두 클래스를 분류하는 이미지 분류 모델을 학습시킬 수 있습니다.
from pathlib import PathPROJECT_DIR = Path.cwd()
DATA_DIR = PROJECT_DIR / 'data' / 'alien_vs_predator'
print(f'프로젝트 폴더: {PROJECT_DIR}')
print(f'데이터 폴더: {DATA_DIR}')
TRAIN_DIR = DATA_DIR / 'train'
VAL_DIR = DATA_DIR / 'validation'
print(f'학습데이터 폴더: {TRAIN_DIR}')
print(f'검증데이터 폴더: {VAL_DIR}')
-------------------------------------------------------------
프로젝트 폴더: c:\JJU\10_MLDL
데이터 폴더: c:\JJU\10_MLDL\data\alien_vs_predator
학습데이터 폴더: c:\JJU\10_MLDL\data\alien_vs_predator\train
검증데이터 폴더: c:\JJU\10_MLDL\data\alien_vs_predator\validation2. Alexnet 모델 활용
from torchvision import transforms, datasets, models이미지넷
이미지넷(ImageNet)은 대규모 이미지 데이터셋으로, 컴퓨터 비전 연구와 딥러닝 모델 학습에 널리 사용됩니다. 2009년 스탠포드 대학의 페이페이 리(Fei-Fei Li) 교수팀이 구축했으며, 약 1,400만 장의 이미지와 22,000개 이상의 카테고리로 구성되어 있습니다. 이 중, 가장 널리 사용되는 ILSVRC(Imagenet Large Scale Visual Recognition Challenge) 버전은 약 1,000개의 클래스와 120만 장의 이미지를 포함합니다. 이미지넷은 모델이 객체를 분류하고 특징을 학습하는 데 필요한 풍부한 데이터와 레이블을 제공하며, ResNet, VGG, Inception 등 여러 혁신적인 모델이 이미지넷 대회를 통해 개발되었습니다. 이 데이터셋은 특히 사전 학습(Transfer Learning)에서 중요한 역할을 하며, 딥러닝 연구의 표준 벤치 마크로 자리 잡았습니다.
IMAGE_SIZE = 224
IMAGENET_MEAN = [0.485, 0.456, 0.406]
IMAGENET_STD = [0.229, 0.224, 0.224]
데이터 증강
- 데이터 증강은 학습 이미지의 모양을 조금씩 바꿔서 과적합을 줄이는 방법
- 실제 서비스에서 발생하지 않을 정도로 이미지로 심하게 회전하거나 찌그러뜨리면 오히려 잘못된 특징을 학습할 수 있으므로 주의
- 원본 데이터의 촬영 방향, 배경, 밝기, 객체 크기를 분석하고 실제 운영 환경에서 발생할 수 있는 변화만 증강에 반영하는 것이 좋음
data_transforms = {
    "train" : transforms.Compose([
        transforms.RandomResizedCrop(IMAGE_SIZE, scale=(0.8, 1.0)),
        transforms.RandomHorizontalFlip(p=0.5),
        transforms.RandomAffine(degrees=8, shear=8),
        transforms.ToTensor(),
        transforms.Normalize(IMAGENET_MEAN, IMAGENET_STD)  # 이미지넷을 사용하려고
    ]),
    "validation" : transforms.Compose([
        transforms.Resize(256),
        transforms.CenterCrop(IMAGE_SIZE), # 컴퓨터 비전에 잘 사용하는 전처리 방식
        transforms.ToTensor(),
        transforms.Normalize(IMAGENET_MEAN, IMAGENET_STD)
    ])
}
# 이미지를 불러와 클래스화 > train과 validation으로 나눔
image_datasets = {
'train' : datasets.ImageFolder(TRAIN_DIR, transform=data_transforms['train']),
'validation' : datasets.ImageFolder(VAL_DIR, transform=data_transforms['validation'])
}class_names = image_datasets['train'].classes
print(class_names)
class_to_idx = image_datasets['train'].class_to_idx
print(class_to_idx)
idx_to_class = {idx: name for name, idx in class_to_idx.items()}
print(idx_to_class)
-----------------------------------------------------------
['alien', 'predator']
{'alien': 0, 'predator': 1}
{0: 'alien', 1: 'predator'}print('학습 데이터 수: ', len(image_datasets['train']))
print('검증 데이터 수: ', len(image_datasets['validation']))
-------------------------------------------------
학습 데이터 수: 694
검증 데이터 수: 200import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoaderif torch.cuda.is_available():
DEVICE = torch.device('cuda')
elif torch.backends.mps.is_available():
DEVICE = torch.device('mps')
elif torch.xpu.is_available():
DEVICE = torch.device('xpu')
else:
DEVICE = torch.device('cpu')
print(DEVICE)# 배치사이즈
BATCH_SIZE = 32
NUM_WORKERS = 0
PIN_MEMORY = DEVICE.type == 'cuda' # 내 환경에 맞는 걸로 넣어주면 됨
SEED = 2026# PyTorch의 난수 생성기를 생성
# 딥러닝에서는 랜덤 요소가 굉장히 많음(가중치, 데이터 섞기, 데이터 증강, train/validation 분리)
# 난수 생성기의 시작값을 고정(재현성)
generator = torch.Generator()
generator.manual_seed(SEED)# persistent_workers : epoch가 끝나면 worker 종료됨
dataloader = {
'train': DataLoader(
image_datasets['train'], batch_size=BATCH_SIZE, shuffle=True,
num_workers=NUM_WORKERS, pin_memory=PIN_MEMORY, generator=generator, persistent_workers=NUM_WORKERS > 0),
'validation': DataLoader(
image_datasets['validation'], batch_size=BATCH_SIZE, shuffle=False,
num_workers=NUM_WORKERS, pin_memory=PIN_MEMORY, persistent_workers=NUM_WORKERS > 0)
}
images , labels = next(iter(dataloader['train']))
print('이미지 배치 shape: ', images.shape)
print('레이블 배치 shape: ', labels.shape)
print('레이블 dtype: ', labels.dtype)
-----------------------------------------------------------------
이미지 배치 shape: torch.Size([32, 3, 224, 224])
레이블 배치 shape: torch.Size([32])
레이블 dtype: torch.int64import matplotlib.pyplot as pltdef denormalize_image(image_tensor):
mean = torch.tensor(IMAGENET_MEAN).view(3, 1, 1)
std = torch.tensor(IMAGENET_STD).view(3, 1, 1)
image = image_tensor.cpu() * std + mean
return image.clamp(0, 1)
images, labels = next(iter(dataloader["train"]))
fig, axes = plt.subplots(2, 4, figsize=(12, 6))
for ax, image, label in zip(axes.flatten(), images[:8], labels[:8]):
ax.imshow(denormalize_image(image).permute(1, 2, 0)) # permute : 차원 위치 바꿔주기
ax.set_title(idx_to_class[label.item()])
ax.axis("off")
plt.tight_layout()
plt.show()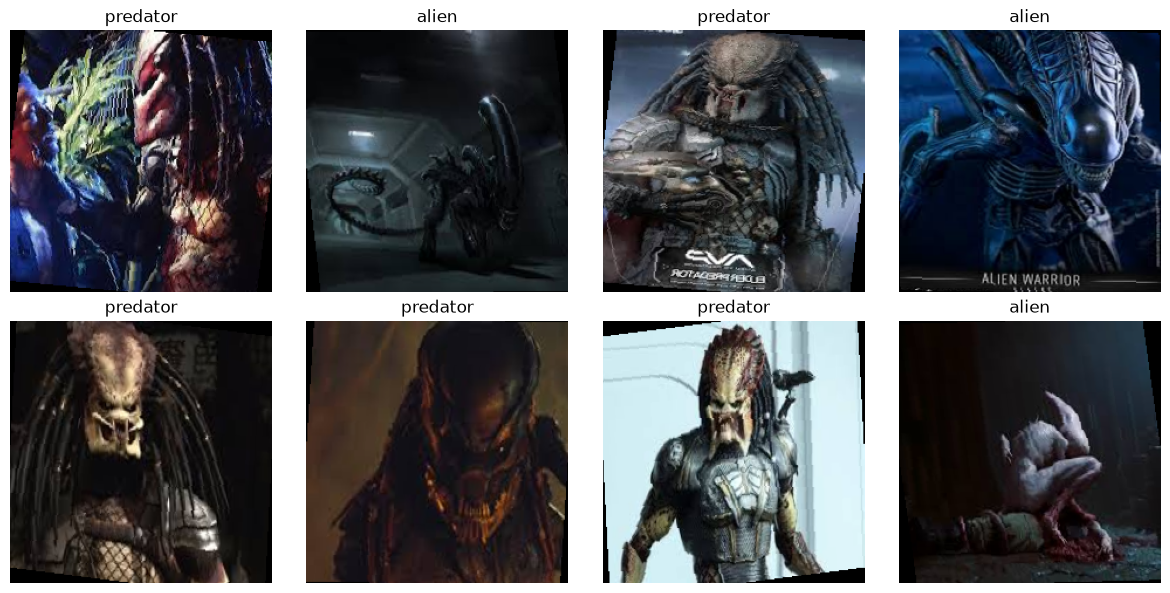
3. 전이 학습
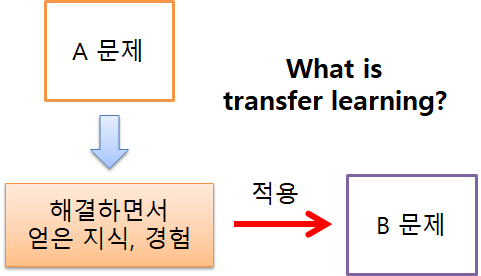
전이 학습(Transfer Learning)은 이미 학습된 모델(주로 대규모 데이터셋에서 사전 학습된 딥러닝 모델)을 새로운 문제에 적용하여 학습 시간을 단축하고 성능을 향상시키는 방법입니다. 기존 모델이 학습한 특징(Feature)을 활용해, 새로운 데이터셋에서 모델의 일부(주로 마지막 레이어)만 다시 학습하거나 추가 학습(Fine-tuning)을 진행합니다. 이는 특히 데이터가 적거나 학습 리소스가 제한된 상황에서 효과적이며, 이미지 분류(예: ResNet, VGG), 자연어 처리(예: BERT, GPT) 등 다양한 분야에서 널리 사용됩니다.
from torchvision.models import AlexNet_Weightsweights = AlexNet_Weights.IMAGENET1K_V1 # 가중치 파일 > 가중치 저장 > 학습한 모델의 파라미터, 레이어가 동일해야 가져다 사용할 수 있음
model = models.alexnet(weights=weights)
model
# features 부분이 특징을 추출하는 CNN Convolution 쪽 > 얼리자 > classifier만 수정해서 우리 프로젝트에 맞게 학습해보자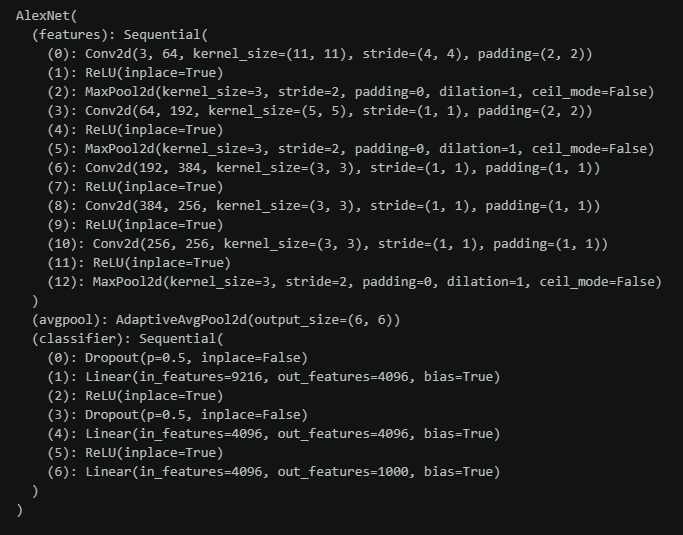
Model Freezing
Model Freezing은 전이 학습(Transfer Learning)에서 사전 학습된 모델의 일부 또는 전체 계층의 가중치를 고정하여 학습되지 않도록 설정하는 기법입니다. 주로 사전 학습된 모델의 초기 계층(Convolution Layers 등)은 일반적인 특징(에: 가장자리, 패턴)을 학습했으므로 고정하고, 새로운 데이터셋에 특화된 특징을 학습하기 위해 최상위 계층(분류 헤드 등)만 학습합니다. 이 방법은 학습할 가중치의 수를 줄여 계산 비용을 절감하고, 과적합을 방지하며, 데이터가 부족한 상황에서 특히 유용합니다. 필요에 따라, 초기 학습이 끝난 후 일부 계층을 고정 해제(Fine-Tuning)하여 모델을 더 정교하게 조정할 수도 있습니다.
- CNN은 이미지 특징을 잘 찾아서 한줄로 넘겨주는 역할을 함 > 열려서 고정(이미 학습이 잘 되어있으니까?)
# parameter 확인
for parameter in model.parameters():
    parameter.requires_grad = False  # 전체 파라미터를 일단 학습하지 못하도록 함.
# FC layer 수정
# 마지막 Linear의 out_features를 1로 변경
# 시그모이드 활용
in_features = model.classifier[6].in_features
model.classifier[6] = nn.Linear(in_features, 1)# 위에서 in_features를 코드작성 했는데 왜 out_features가 바뀐거지?
model = model.to(DEVICE)
model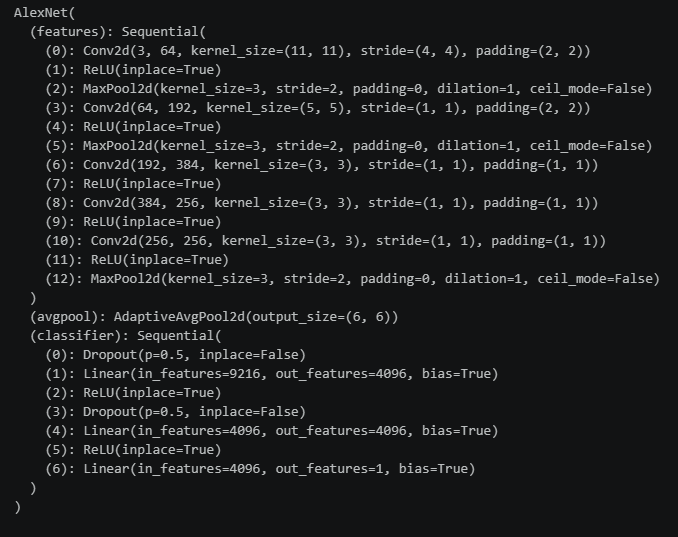
# 전체 파라미터 수 출력
total_params = sum(p.numel() for p in model.parameters())
trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)  # p.requires_grad가 True일 때만
print(f'전체 파라미터 수: {total_params:,}')
print(f'학습 가능한 파라미터 수: {trainable_params}')  # 왜 이렇게 나오는지 확인
-------------------------------------------------------------
전체 파라미터 수: 57,007,937
학습 가능한 파라미터 수: 4097
BCEWithLogistLoss
- 이진 분류에서 모델은 확률이 아니라 logit이라는 실수 값을 출력
- 학습 시: BCEWithLogitsLoss(logit, 정답)
- 예측 시: torch.sigmoid(logit)으로 0~1 확률 변환
Sigmoid와 BCELoss를 따로 적용하는 방식보다 큰 양수나 음수 값에서 수치적으로 더 안정적으로 계산
criterion = nn.BCEWithLogitsLoss()
optimizer = optim.AdamW(filter(lambda p: p.requires_grad, model.parameters()),
                        lr=1e-3, weight_decay=1e-4)
scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer, mode='min', factor=0.5, patience=2)
print('초기 학습률: ', optimizer.param_groups[0]['lr'])
-------------------------------------------------------
초기 학습률:  0.001
# NVIDIA CUDA GPU를 사용한다면 AMP를 사용함
# AMP(Automatic Mixed Precision): 자동 혼합 정밀도 연산
# FP32에서는 값을 비교적 잘 표현할 수 있지만, FP16에서는 너무 값이 사라져버릴 수 있음: underflow
# gradient가 0이 되어버리면 gradient 자체가 가중치를 제대로 업데이트하지 못함
# cpu는 굳이 코드 작성할 필요 없음
# 자신의 gpu상태에 맞춰서 작성
use_amp = DEVICE.type == 'cuda'
# loss를 일시적으로 크게 만들어서 작은 gradient가 사라지는 것을 방지
scaler = torch.amp.GradScaler('cuda', enabled=use_amp)def run_epoch(model, loader, criterion, device, optimizer=None):
is_training = optimizer is not None
if is_training:
model.train()
else:
model.eval()
running_loss = 0.0
running_correct = 0
running_samples = 0
grad_context = torch.enable_grad() if is_training else torch.inference_mode()
with grad_context:
for images, labels in loader:
images = images.to(device, non_blocking=PIN_MEMORY) # PIN_MEMORY를 사용해야 병렬로 처리되고 효과가 있음
labels = labels.float().unsqueeze(1).to(device, non_blocking=PIN_MEMORY)
if is_training:
optimizer.zero_grad()
with torch.autocast(device_type=device.type, dtype=torch.float16): # casting, 메모리 절약을 위해 소수점을 16자리로 잘라줌
logits = model(images)
loss = criterion(logits, labels)
if is_training:
# scaler : 메모리를 아껴쓰려고
scaler.scale(loss).backward() # loss값에 의해서 역전파 > 기울기가 사라지려고 하면 loss값을 좀 키워줌
scaler.step(optimizer)
scaler.update() # update를 작성해야 전체적으로 scaler가 적용됨
probabilities = torch.sigmoid(logits)
predictions = (probabilities >= 0.5).float()
batch_size = labels.size(0)
running_loss += loss.item() * batch_size
running_correct += (predictions == labels ).sum().item()
running_samples += batch_size
# 평균
epoch_loss = running_loss / running_samples
epoch_accuracy = running_correct / running_samples
return epoch_loss, epoch_accuracyEPOCHS = 10
EARLY_STOPPING_PATIENCE = 5
MODEL_PATH = PROJECT_DIR / 'best_alien_predator_alexnet.pth'
history = { 'train_loss': [], 'train_acc': [], 'val_loss': [], 'val_acc': [] }
best_val_loss = float('inf')
epochs_without_improvement = 0for epoch in range(1, EPOCHS + 1) :
train_loss, train_acc = run_epoch(model=model, loader=dataloaders['train'], criterion=criterion,
device=DEVICE, optimizer=optimizer)
val_loss, val_acc = run_epoch(model=model, loader=dataloaders['validation'], criterion=criterion,
device=DEVICE, optimizer=None)
scheduler.step(val_loss)
current_lr = optimizer.param_groups[0]['lr']
history['train_loss'].append(train_loss)
history['train_acc'].append(train_acc)
history['val_loss'].append(val_loss)
history['val_acc'].append(val_acc)
print(
f'Epoch {epoch:02d}/{EPOCHS} | '
f'Train Loss {train_loss:.4f} | Train Acc {train_acc * 100:.2f}% | '
f'Val Loss {val_loss:.4f} | Val Acc {val_acc * 100:.2f}% | '
f'LR {current_lr:.2e}'
)
if val_loss > best_val_loss:
best_val_loss = val_loss
epochs_without_improvement = 0
torch.save({
"model_state_dict" : model.state_dict(),
"class_to_idx" : class_to_idx,
"image_size": IMAGE_SIZE,
"mean": IMAGENET_MEAN,
"std": IMAGENET_STD,
"best_val_loss": best_val_loss
}, MODEL_PATH) # MODEL_PATH에 저장
print(f'최고 모델 저장: {MODEL_PATH.name}')
else:
epochs_without_improvement += 1
if epochs_without_improvement >= EARLY_STOPPING_PATIENCE:
print('검증 손실이 개선되지 않아 Early Stopping을 적용합니다.')
break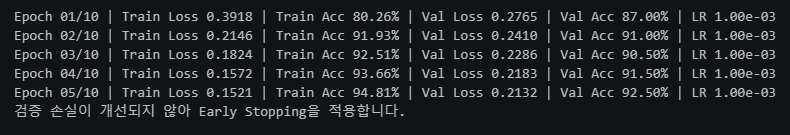
import numpy as npepoch_range = range(1, len(history["train_loss"]) + 1)
plt.figure(figsize=(8, 5))
plt.plot(epoch_range, history["train_loss"], marker="o", label="Train Loss")
plt.plot(epoch_range, history["val_loss"], marker="o", label="Validation Loss")
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Training and Validation Loss")
plt.legend()
plt.grid(alpha=0.3)
plt.show()
plt.figure(figsize=(8, 5))
plt.plot(epoch_range, np.array(history["train_acc"]) * 100, marker="o", label="Train Accuracy")
plt.plot(epoch_range, np.array(history["val_acc"]) * 100, marker="o", label="Validation Accuracy")
plt.xlabel("Epoch")
plt.ylabel("Accuracy (%)")
plt.title("Training and Validation Accuracy")
plt.legend()
plt.grid(alpha=0.3)
plt.show()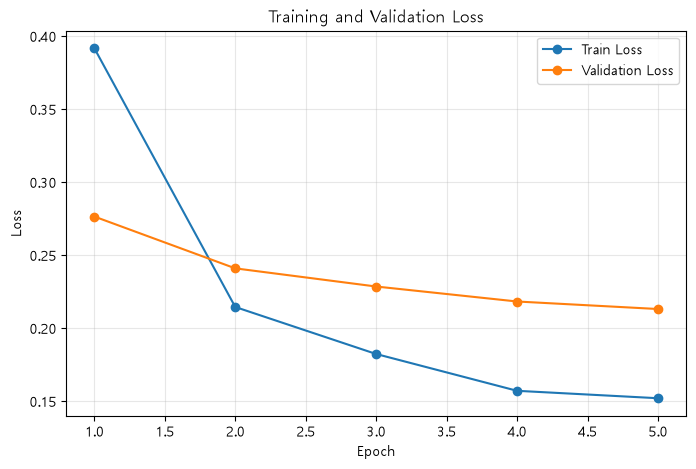

checkpoint = torch.load(MODEL_PATH, map_location=DEVICE, weights_only=True)
model.load_state_dict(checkpoint['model_state_dict'])
model.eval()

print(f'최고 검증 손실: {checkpoint['best_val_loss']:.4f}')
print(f'저장된 클래스 정보: {checkpoint['class_to_idx']}')
4. 단일 이미지 예측
# 단일 이미지를 넣어서 분류를 잘 맞추는지 확인
from PIL import Image
def predict_image(image_path, model, transform, device, idx_to_class):
image_path = Path(image_path)
if not image_path.exists():
raise FileNotFoundError(f'이미지 파일을 찾을 수 없습니다. {image_path}')
image = Image.open(image_path).convert("RGB")
input_tensor = transform(image).unsqueeze(0).to(DEVICE)
model.eval()
with torch.inference_mode():
logit = model(input_tensor)
class_1_probability = torch.sigmoid(logit).item() # Torch객체니까 값을 뽑아내려면 .item()
probabilities = {
idx_to_class[0]: 1.0 - class_1_probability, # 0일 확률
idx_to_class[1]: class_1_probability # 1일 확률
}
predicted_class = max(probabilities, key=probabilities.get)
return image, predicted_class, probabilitiessample_paths = []
# class_name : alien, predator
for class_name in class_names:
class_dir = VAL_DIR / class_name
candidates = sorted(p for p in class_dir.iterdir() if p.suffix.lower() # 확장명을 소문자로 > 정렬
in {".jpg", ".jpeg", ".png", ".bmp", ".webp"})
if candidates:
sample_paths.append(candidates[0])# subplot 생성
fig, axes = plt.subplots(1, len(sample_paths), figsize=(6 * len(sample_paths), 5))
if len(sample_paths) == 1:
axes = [axes] # axes를 리스트로 만듦
for ax, sample_path in zip(axes, sample_paths):
image, predicted_class, probabilities = predict_image(
image_path=sample_path,
model=model,
transform=data_transforms["validation"],
device=DEVICE,
idx_to_class=idx_to_class,
)
probability_text = " | ".join(
f"{name}: {probability * 100:.2f}%"
for name, probability in probabilities.items()
)
ax.imshow(image)
ax.set_title(f"예측: {predicted_class}\n{probability_text}")
ax.axis("off")
plt.tight_layout()
plt.show()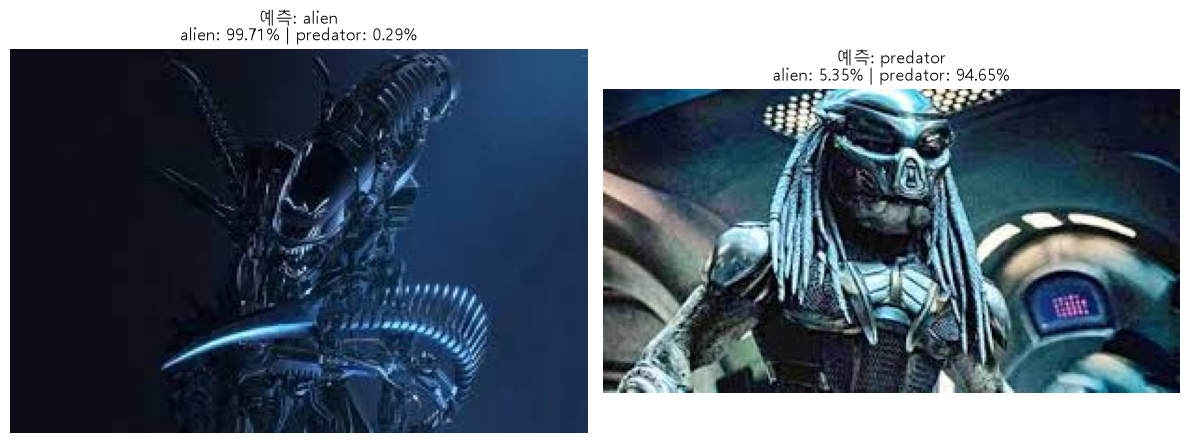
from sklearn.metrics import classification_report, ConfusionMatrixDisplayall_labels = []
all_predictions= []
model.eval()
with torch.inference_mode():
for images, labels in dataloaders['validation']:
images = images.to(DEVICE, non_blocking=PIN_MEMORY)
logits = model(images)
probabilities = torch.sigmoid(logits).squeeze(1) # 1인 채널은 없앰
predictions = (probabilities >= 0.5).long().cpu()
all_labels.extend(labels.tolist())
all_predictions.extend(predictions.tolist())
print(classification_report(all_labels, all_predictions, target_names=class_names,
digits=4, zero_division=0))
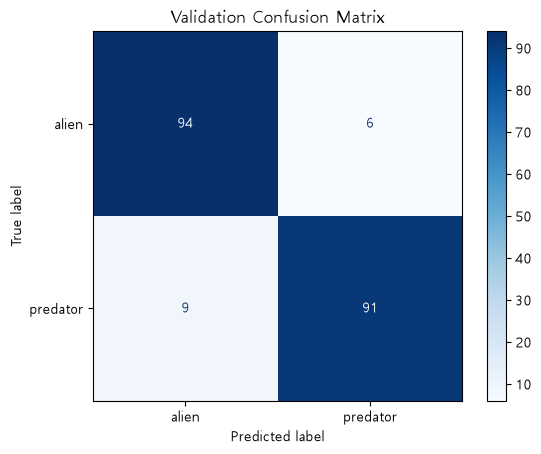
ConfusionMatrixDisplay.from_predictions(all_labels, all_predictions, display_labels=class_names,
cmap="Blues")
plt.title('Validation Confusion Matrix')
plt.show()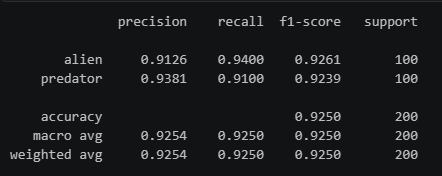
MY_IMAGE_PATH = DATA_DIR / '로켓.png'

image, predicted_class, probabilities = predict_image(
    image_path=MY_IMAGE_PATH,
    model=model,
    transform=data_transforms["validation"],
    device=DEVICE,
    idx_to_class=idx_to_class,
)

for class_name, probabilities in probabilities.items():
    print(f'{class_names}: {probabilities * 100:.2f}%')

print(f'결과: 나는 {predicted_class} 쪽에 가깝습니다.')
----------------------------------------------------------------------
['alien', 'predator']: 18.44%
['alien', 'predator']: 81.56%
결과: 나는 predator 쪽에 가깝습니다.
# 1. 테스트할 사진 경로 설정
sample_paths = [
Path("data/alien_vs_predator/로켓.png"),
Path("data/alien_vs_predator/alien.png")
]
# 2. Subplot 생성 및 예측 시각화 (작성하신 코드)
fig, axes = plt.subplots(1, len(sample_paths), figsize=(6 * len(sample_paths), 5))
if len(sample_paths) == 1:
axes = [axes] # axes를 리스트로 변환
for ax, sample_path in zip(axes, sample_paths):
image, predicted_class, probabilities = predict_image(
image_path=sample_path,
model=model,
transform=data_transforms["validation"],
device=DEVICE,
idx_to_class=idx_to_class,
)
probability_text = " | ".join(
f"{name}: {probability * 100:.2f}%"
for name, probability in probabilities.items()
)
ax.imshow(image)
ax.set_title(f"예측: {predicted_class}\n{probability_text}")
ax.axis("off")
plt.tight_layout()
plt.show()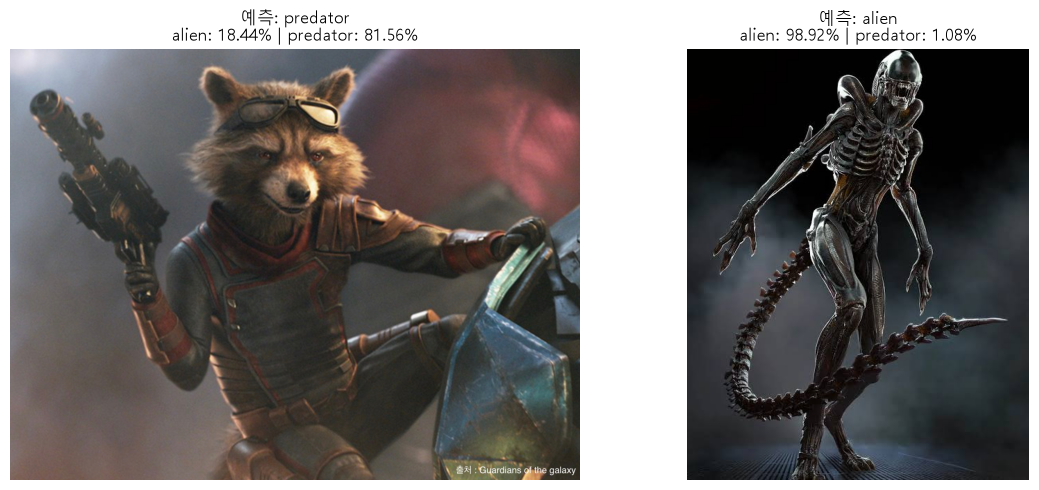
'인공지능 > 딥러닝' 카테고리의 다른 글
| AlexNet (0) | 2026.08.24 |
|---|---|
| 손글씨 도형 분류하기 (0) | 2026.08.20 |
| CNN (0) | 2026.08.20 |